State of GPT
Andrej Karpathy, membro fundador da OpenAI, apresentou no Microsoft Build o pipeline usado para treinar o GPT.
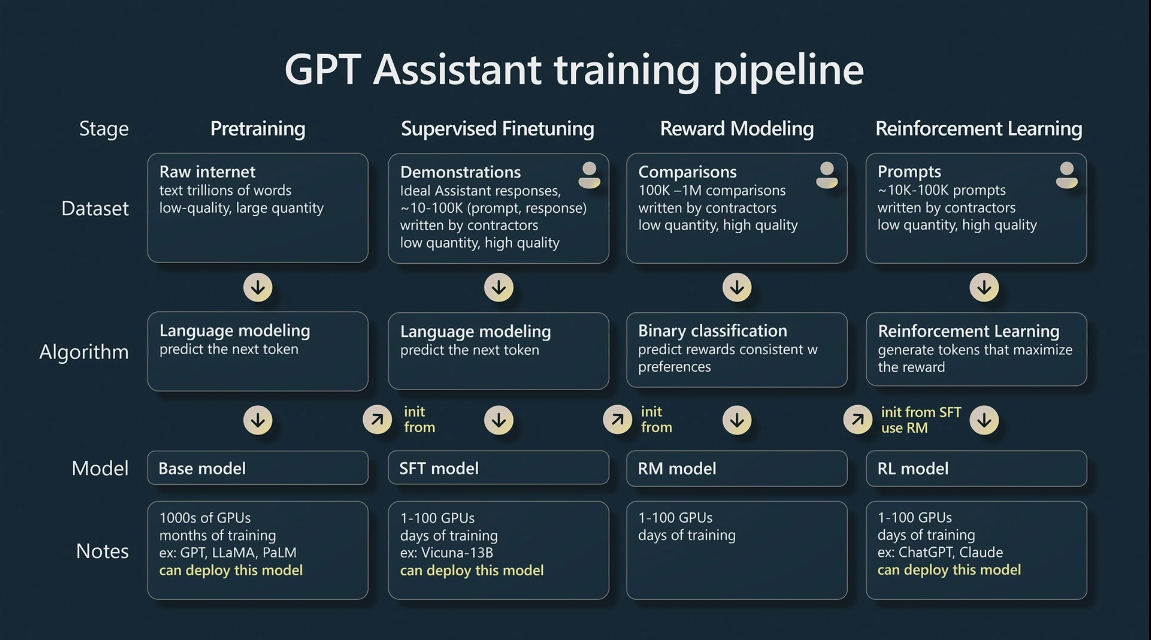
Em cada etapa desse pipeline são usados datasets e algoritmos, e o resultado é um modelo treinado. A primeira etapa é o pré-treinamento, onde acontece todo o trabalho computacional pesado: milhares de GPUs, meses de treinamento e milhões de dólares.
São coletados dados disponíveis publicamente em sites como CommonCrawl (web scraper), Wikipedia, Github, entre outros.
Antes de usar toda essa informação para treinar o modelo, é feita a tokenização, que é o processo nativo que o GPT usa. A tokenização converte o texto em uma sequência de números inteiros. Em média, 1 token equivale a 0,75 palavra em inglês.
Se ficou difícil de entender, você pode acessar o site da OpenAI para ter uma visão mais clara: OpenAI Tokenizer.
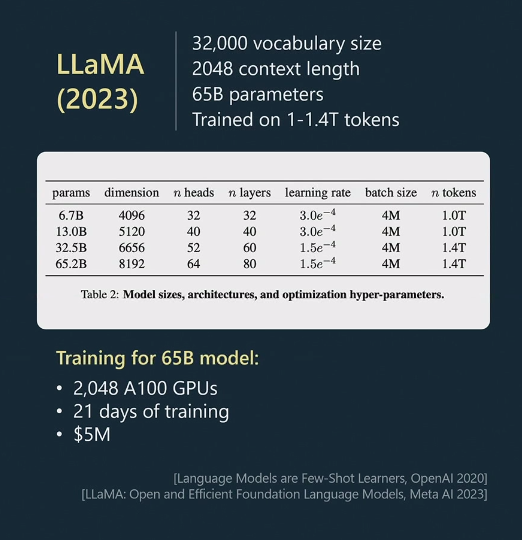
Durante o treinamento do modelo, são considerados os seguintes aspectos:
- Tamanho do vocabulário.
- Tamanho do contexto.
- Parâmetros.
- Número de tokens usados durante o treinamento.
A imagem 2 representa o modelo LLaMA, desenvolvido pela Meta.
Em seguida, a entrada passada para o Transformer é organizada em batches, que basicamente são arrays com o tamanho do batch e o tamanho do contexto. O que esse Transformer faz é tentar prever a próxima palavra, já que cada token só consegue ver os tokens do mesmo batch e os que vêm antes dele. O New York Times treinou um modelo GPT usando textos de Shakespeare. Para saber mais, confira: GPT from Scratch NYT.
Conforme o modelo passa por mais iterações de treinamento, ele fica mais preciso em prever a próxima palavra.
Depois desse processo, temos o nosso modelo base, que foi treinado com muita informação, mas de “baixa qualidade”. Por isso, a etapa seguinte se concentra em refinar o modelo (fine-tuning) usando menos informação, mas de “alta qualidade”.
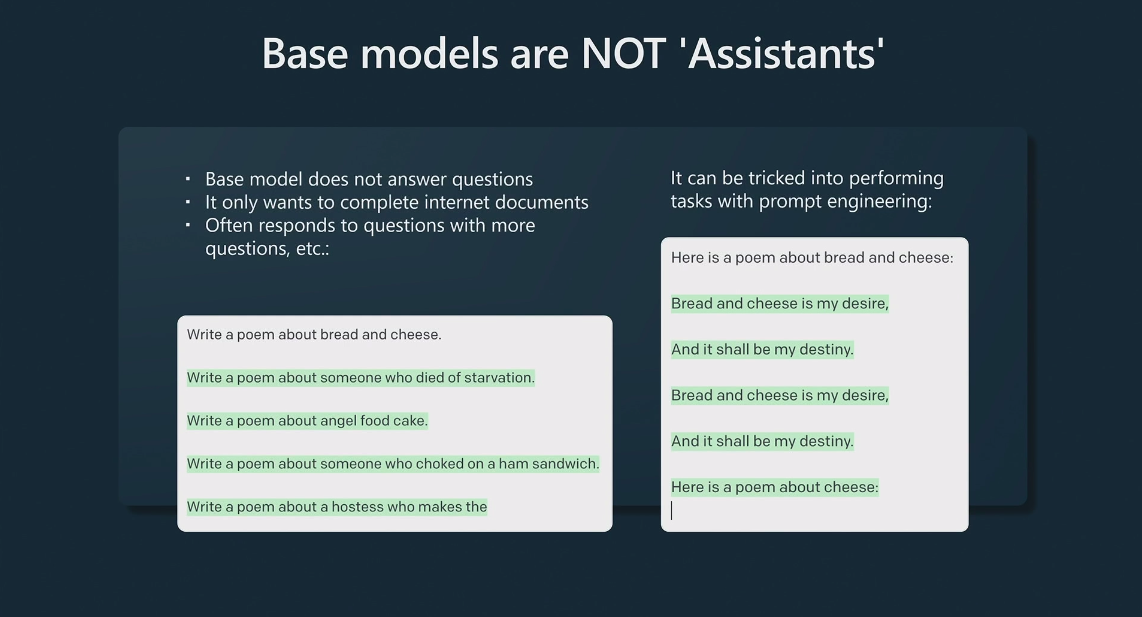
Uma das coisas mais importantes que o Andrej menciona é que modelos base não são assistentes; o objetivo principal deles é completar documentos.
Os modelos STF são treinados com um processo parecido, mas com datasets menores e de maior qualidade, focados em responder perguntas e executar tarefas específicas.
Depois da segunda fase, já daria para considerar o pipeline completo, mas também é possível adicionar etapas extras usando RLHF (Reinforcement Learning from Human Feedback). Na etapa de reward modeling, os resultados de um mesmo prompt (completions) são comparados e classificados de acordo com a qualidade.
Na última etapa, com as completions de um prompt específico já classificadas, o modelo consegue escolher a melhor completion com base na avaliação.
O ChatGPT é um exemplo de modelo RLHF.
Modelos RLHF tendem a gerar resultados com menos variação, enquanto os modelos base tendem a ser mais diversos, o que pode ser útil em certos contextos.
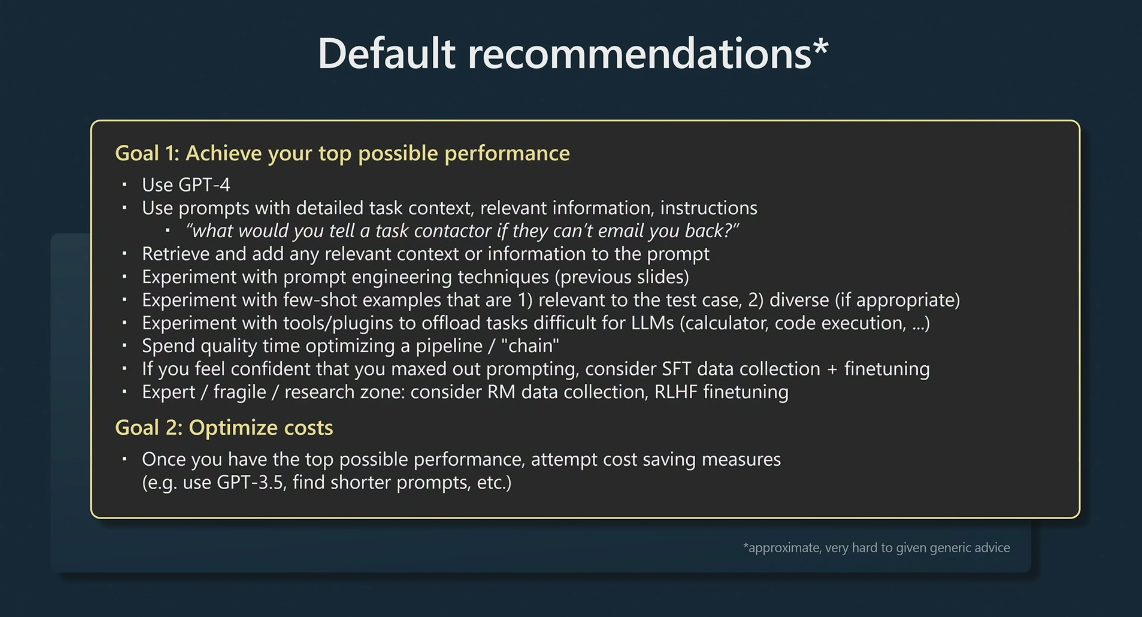
Na segunda parte da palestra, o Andrej compartilhou várias dicas para conseguir resultados melhores com LLMs:
- Às vezes, os LLMs podem dar azar e gerar uma amostra ruim, então o recomendado é fazer várias tentativas.
- Faça perguntas reflexivas para os LLMs; eles sabem quando erram.
- Os LLMs não buscam o sucesso no sentido convencional; o objetivo principal deles é imitar os datasets de treinamento. Se você quer que eles acertem em um sentido específico, precisa formular suas perguntas de um jeito que deixe esse objetivo claro. Por exemplo: “Você é um desenvolvedor especialista com QI de 120.” Mas é importante ser realista para evitar que os LLMs recorram a fontes fictícias, como ficção científica.
Se você tiver 45 minutos, pode assistir à palestra completa aqui: Microsoft Build 2023 Andrej Karpathy