State of GPT
Andrej Karpathy, miembro fundador de OpenAI, compartió en Microsoft Build el pipeline que se usa para entrenar GPT.
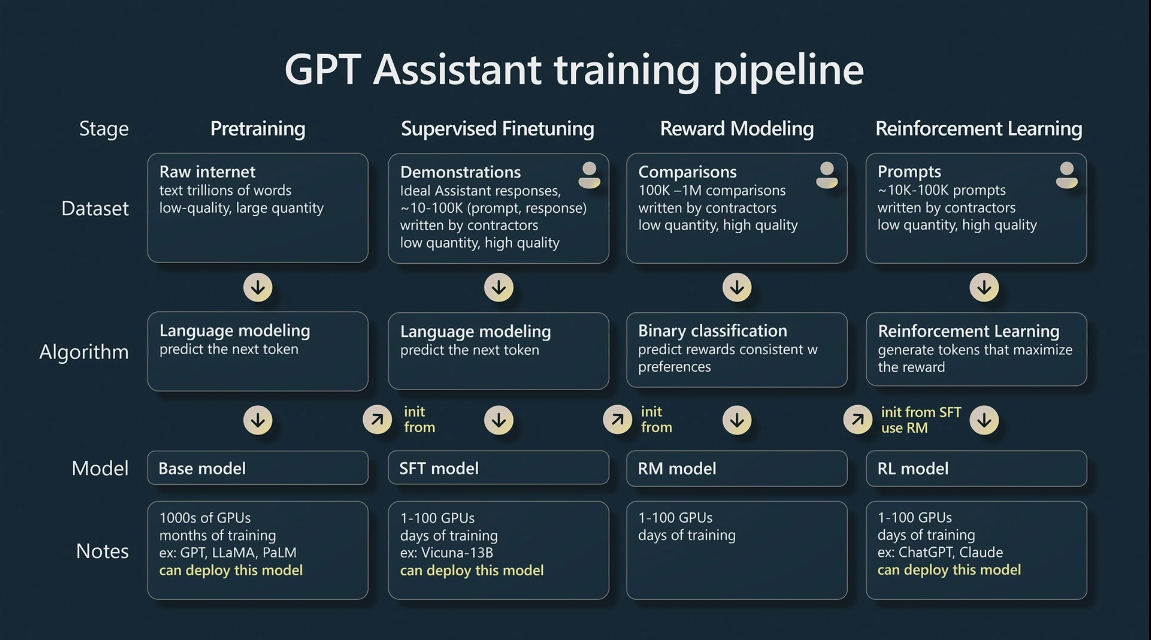
En cada una de las etapas de este pipeline se usan datasets y algoritmos, y el resultado es un modelo entrenado. La primera etapa es el preentrenamiento, donde se hace todo el trabajo computacional usando miles de GPUs durante meses de entrenamiento y millones de dólares.
Se recopilan datos públicos de sitios como CommonCrawl (web scraper), Wikipedia, Github, entre otros.
Antes de meter toda esta información para entrenar el modelo, se hace la tokenización, que es el proceso nativo que usa GPT. La tokenización convierte el texto en una secuencia de números enteros. Aproximadamente, 1 token equivale a 0.75 palabras en inglés.
Si se te hace difícil de entender, puedes visitar el sitio de OpenAI para verlo más claro: OpenAI Tokenizer.
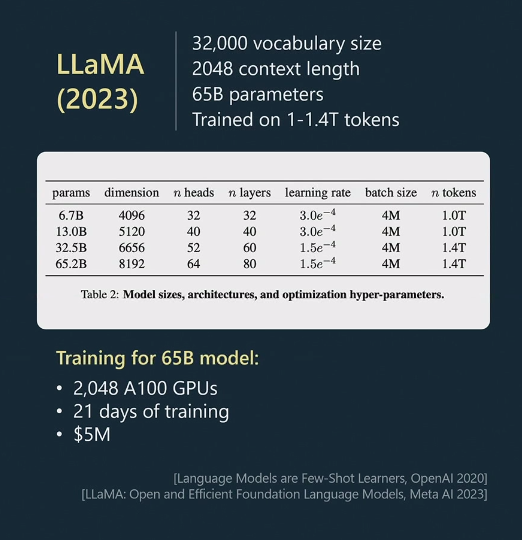
Durante el entrenamiento del modelo se toman en cuenta los siguientes aspectos:
- Tamaño del vocabulario.
- Longitud de contexto.
- Parámetros.
- Número de tokens usados durante el entrenamiento.
La imagen 2 representa el modelo LLaMA desarrollado por Meta.
Después, el input que se le da al Transformer se organiza en batches, que básicamente son arreglos con tamaño de batch y longitud de contexto. Lo que hace este Transformer es intentar predecir la siguiente palabra, ya que cada token solo puede ver los tokens del mismo batch y los que vienen antes que él. The New York Times entrenó un modelo GPT usando textos de Shakespeare. Para más información, échale un ojo a: GPT from Scratch NYT.
Conforme el modelo pasa por más iteraciones de entrenamiento, se vuelve más preciso para predecir la siguiente palabra.
Después de este proceso tenemos nuestro modelo base, que se entrenó con muchísima información pero de “baja calidad”. Por eso la siguiente etapa se enfoca en refinar el modelo (fine-tuning) usando menos información pero de “alta calidad”.
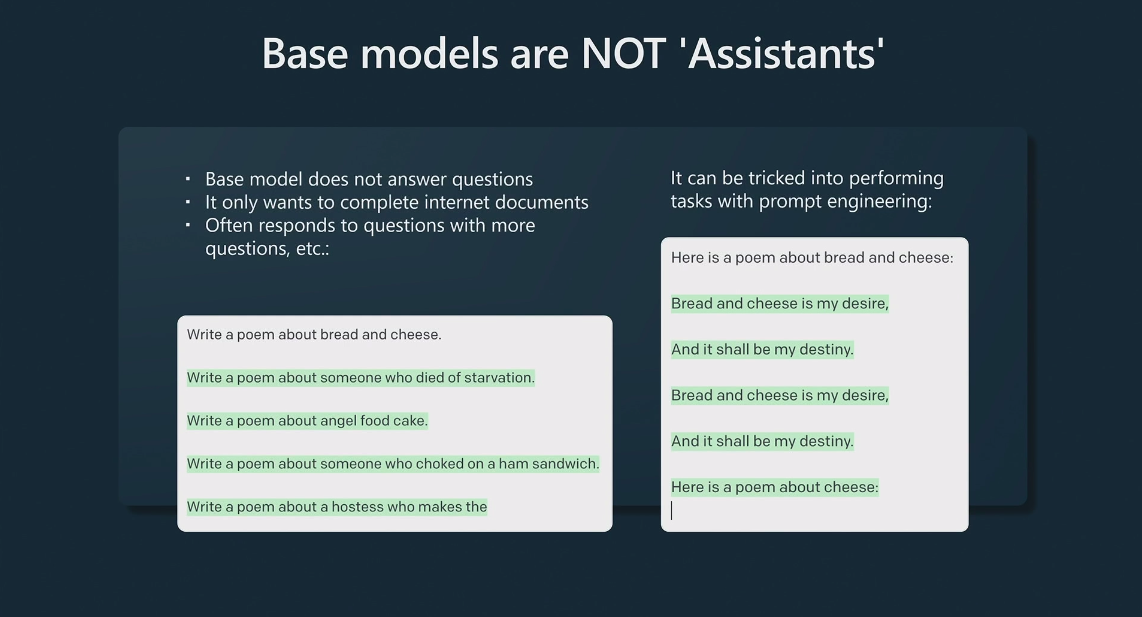
Una de las cosas más importantes que menciona Andrej es que los modelos base no son asistentes; su objetivo principal es completar documentos.
Los modelos STF se entrenan con un proceso parecido, pero con datasets más pequeños y de mayor calidad, enfocados en responder preguntas y hacer tareas específicas.
Después de la segunda fase podríamos considerar que el pipeline está completo, aunque también se pueden agregar etapas adicionales usando RLHF (Reinforcement Learning from Human Feedback). En la etapa de reward modeling, se comparan los resultados de un mismo prompt (completions) y se clasifican según su calidad.
En la última etapa, una vez que tenemos las completions clasificadas para un prompt específico, el modelo puede elegir la mejor completion con base en la evaluación.
ChatGPT es un ejemplo de un modelo RLHF.
Los modelos RLHF tienden a generar resultados con menos variación, mientras que los modelos base suelen ser más diversos, lo cual puede ser útil en ciertos contextos.
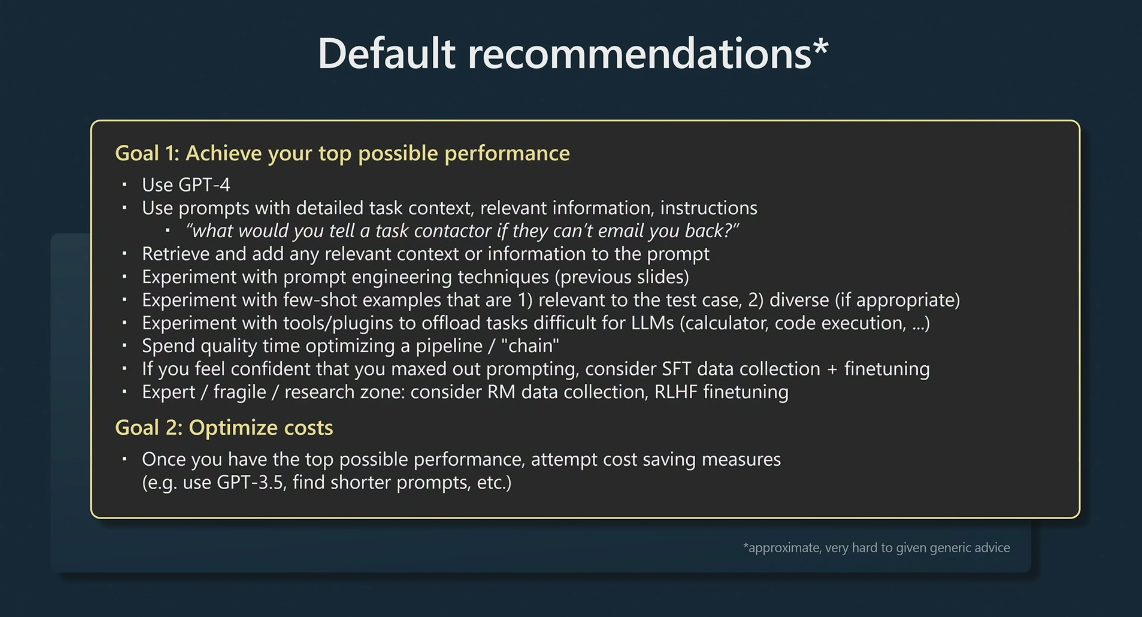
En la segunda parte de la charla, Andrej compartió varios tips para obtener mejores resultados con LLMs:
- A veces los LLMs pueden tener mala suerte y generar una mala muestra, así que se recomienda hacer varios intentos.
- Hazle preguntas reflexivas a los LLMs; saben cuándo se equivocan.
- Los LLMs no buscan el éxito en el sentido convencional; su objetivo principal es imitar los datasets de entrenamiento. Si quieres que tengan éxito en un sentido específico, tienes que formular tus preguntas de forma que dejen claro ese objetivo. Por ejemplo, “Eres un desarrollador experto con un IQ de 120”. Eso sí, es importante ser realista para evitar que los LLMs terminen recurriendo a fuentes ficticias como la ciencia ficción.
Si tienes 45 minutos, puedes ver la charla completa aquí: Microsoft Build 2023 Andrej Karpathy