State of GPT
OpenAIの創設メンバーである**アンドレイ・カルパシー(Andrej Karpathy)**が、Microsoft BuildでGPTの学習に使われているパイプラインを紹介した。
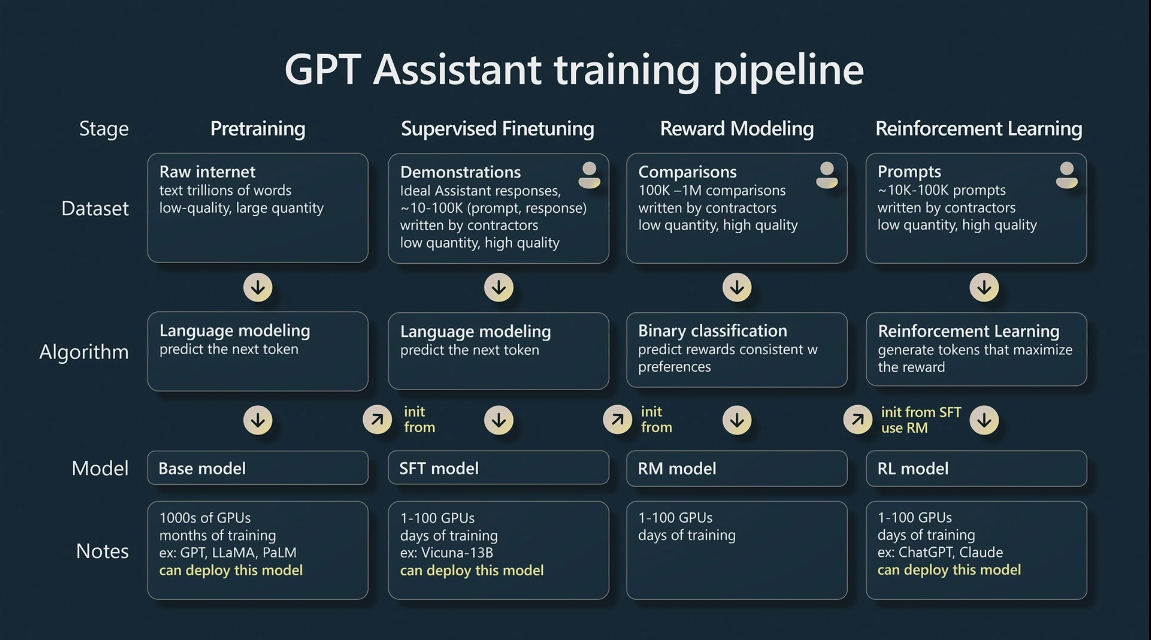
このパイプラインの各ステージではデータセットとアルゴリズムが使われ、その結果として学習済みモデルができあがる。最初のステージは事前学習で、ここに計算処理のほぼすべてが集中する。数千台のGPUを使い、数か月にわたる学習と数百万ドルのコストがかかる。
データは、CommonCrawl(Webスクレイパー)、Wikipedia、Githubなど、公開されているサイトから収集される。
こうした情報をすべてモデルの学習に投入する前に、GPTにとってネイティブな処理であるトークン化が行われる。トークン化とは、テキストを整数の列に変換することだ。おおよそ、1トークンは英語の0.75単語に相当する。
イメージしにくければ、OpenAIのサイトを見るとよく分かる:OpenAI Tokenizer。
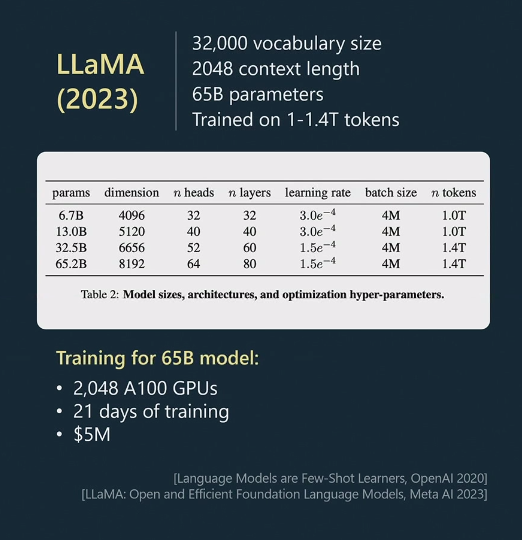
モデルの学習では、次の要素が考慮される。
- 語彙サイズ。
- コンテキスト長。
- パラメータ数。
- 学習に使われるトークン数。
画像2は、Metaが開発したLLaMAモデルを表している。
次に、Transformerへの入力はバッチにまとめられる。これは要するに、バッチサイズとコンテキスト長を持つ配列だ。Transformerがやっているのは次の単語の予測であり、各トークンは同じバッチ内の、自分より前にあるトークンしか参照できない。ニューヨーク・タイムズは、シェイクスピアのテキストを使ってGPTモデルを学習させている。詳しくはこちら:GPT from Scratch NYT。
学習のイテレーションを重ねるほど、モデルは次の単語をより正確に予測できるようになる。
このプロセスを経て得られるのがベースモデルだ。大量の情報で学習しているが、その情報は「低品質」である。そのため次のステージでは、量は少ないが「高品質」な情報を使ってモデルを洗練させること(ファインチューニング)に焦点を当てる。
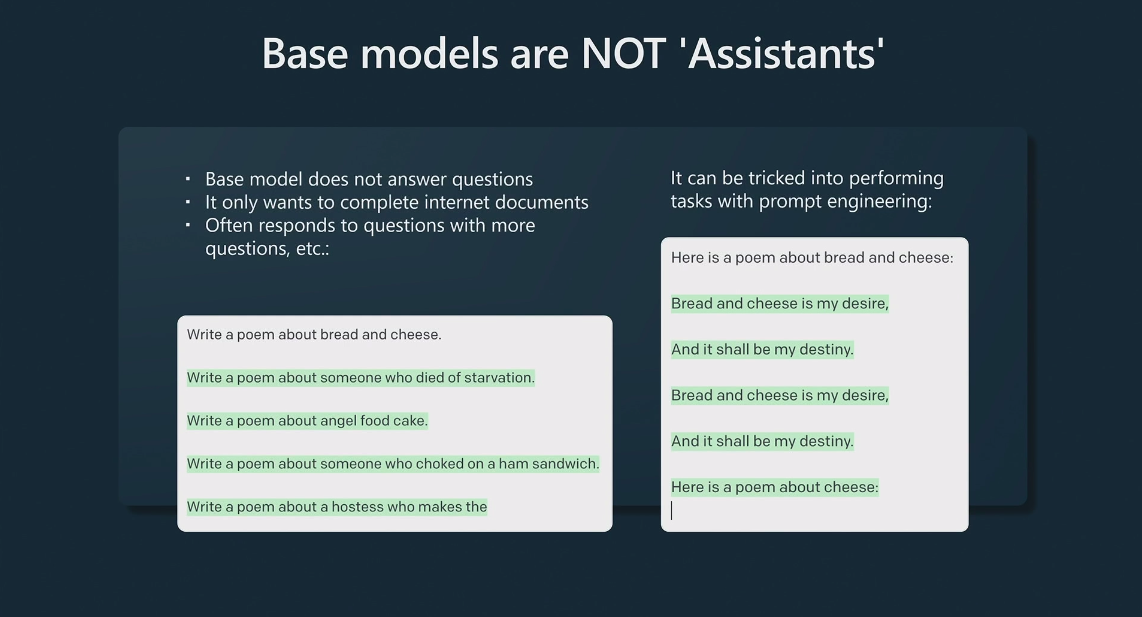
アンドレイが語ったなかで特に重要なのは、ベースモデルはアシスタントではない、という点だ。ベースモデルの主な目的は、ドキュメントを補完することにある。
STFモデルも同様のプロセスで学習されるが、使われるのはより小規模で高品質なデータセットであり、質問への回答や特定タスクの実行に特化している。
第2フェーズが終われば、パイプラインは完成したと見なすこともできる。ただし、RLHF(人間のフィードバックによる強化学習)を使ってさらにステージを追加することも可能だ。報酬モデリングのステージでは、同じプロンプトに対する出力(コンプリーション)同士を比較し、品質に基づいてランク付けする。
最後のステージでは、特定のプロンプトに対するコンプリーションがランク付けされた状態になっているので、モデルは評価に基づいて最良のコンプリーションを選べるようになる。
ChatGPTはRLHFモデルの一例だ。
RLHFモデルは出力のばらつきが小さくなる傾向がある。一方でベースモデルは出力が多様になりやすく、文脈によってはそれが役に立つこともある。
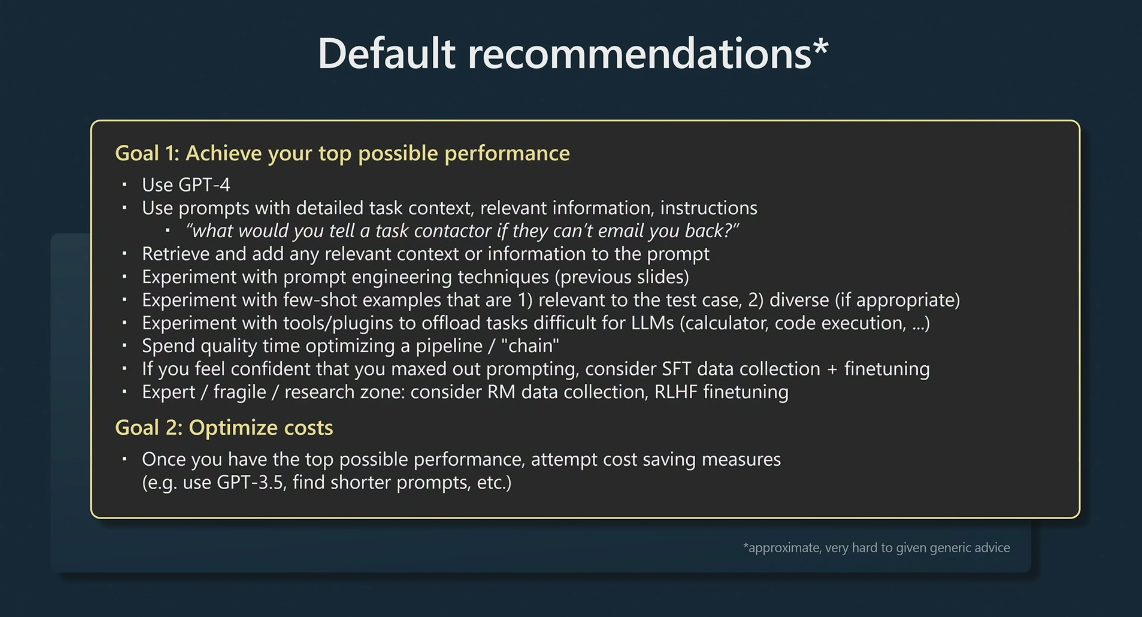
講演の後半では、アンドレイがLLMでより良い結果を得るためのコツをいくつか紹介していた。
- LLMも運が悪くて質の低いサンプルを出すことがあるので、何度か試すのがおすすめだ。
- LLMに振り返りを促す質問をするといい。LLMは自分が間違えたときにそれを分かっている。
- LLMは一般的な意味での「成功」を目指しているわけではなく、主な目的は学習データセットを模倣することだ。特定の意味で成功してほしいなら、その目標がはっきり伝わるように質問を組み立てる必要がある。たとえば「あなたはIQ120のエキスパート開発者です」のように。ただし、LLMがSFのような架空のソースに頼ってしまわないよう、現実的な設定にすることが大切だ。
45分ほど時間があれば、講演の全編はこちらで見られる: Microsoft Build 2023 Andrej Karpathy