State of GPT
OpenAI의 창립 멤버인 안드레이 카파시(Andrej Karpathy)가 Microsoft Build에서 GPT를 학습시키는 데 쓰이는 파이프라인을 소개했어요.
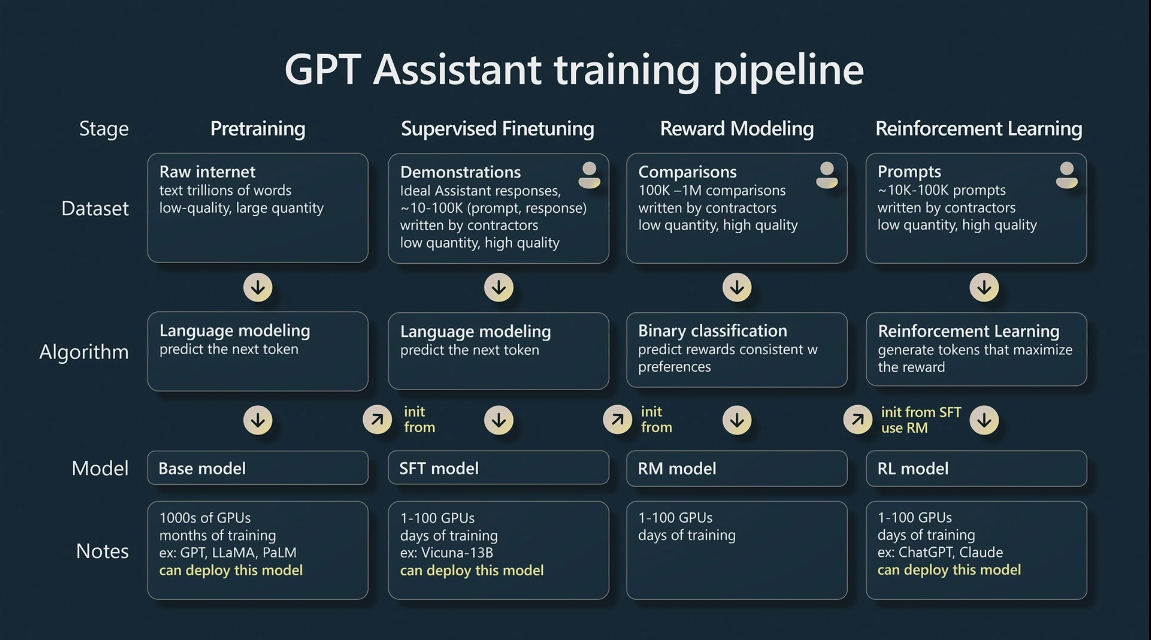
이 파이프라인의 각 단계에서는 데이터셋과 알고리즘이 사용되고, 그 결과로 학습된 모델이 나와요. 첫 번째 단계는 사전 학습(pretraining)인데, 수천 개의 GPU로 몇 달에 걸쳐 학습하며 수백만 달러가 드는, 연산 작업의 대부분이 이루어지는 단계예요.
데이터는 CommonCrawl(웹 스크레이퍼), Wikipedia, Github 등의 웹사이트에서 공개적으로 이용 가능한 것을 수집해요.
이 모든 정보를 모델 학습에 넣기 전에 토큰화를 거치는데, 이게 GPT가 기본적으로 사용하는 처리 방식이에요. 토큰화는 텍스트를 정수 시퀀스로 변환해요. 영어 기준으로 대략 1토큰이 0.75단어에 해당해요.
이해하기 어렵다면 OpenAI 웹사이트에서 좀 더 직관적으로 확인해 볼 수 있어요: OpenAI Tokenizer.
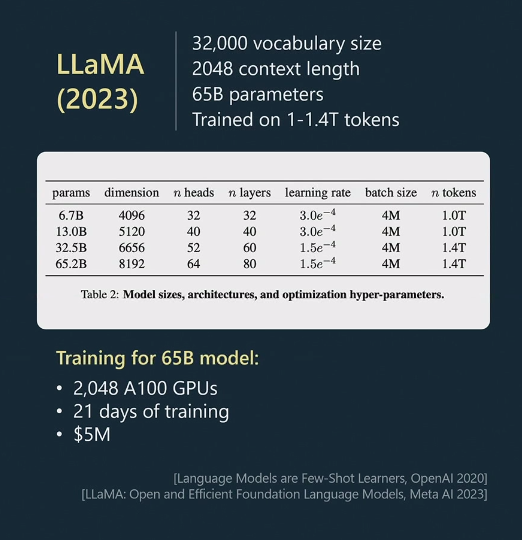
모델을 학습시킬 때는 다음 요소들을 고려해요.
- 어휘 크기.
- 컨텍스트 길이.
- 파라미터.
- 학습에 사용된 토큰 수.
이미지 2는 Meta가 개발한 LLaMA 모델을 나타내요.
그다음 Transformer에 들어가는 입력은 배치로 구성되는데, 배치란 결국 배치 크기와 컨텍스트 길이를 갖는 배열이에요. Transformer가 하는 일은 다음 단어를 예측하는 것으로, 각 토큰은 같은 배치 안에서 자신보다 앞에 있는 토큰만 볼 수 있어요. 뉴욕타임스는 셰익스피어의 텍스트로 GPT 모델을 학습시켜 보기도 했어요. 자세한 내용은 여기서 볼 수 있어요: GPT from Scratch NYT.
학습 반복을 거듭할수록 모델은 다음 단어를 더 정확하게 예측하게 돼요.
이 과정을 마치면 베이스 모델이 생겨요. 많은 정보로 학습했지만 그 정보는 ’저품질’이에요. 그래서 다음 단계에서는 더 적지만 ’고품질’인 정보로 모델을 다듬는 데(파인튜닝) 집중해요.
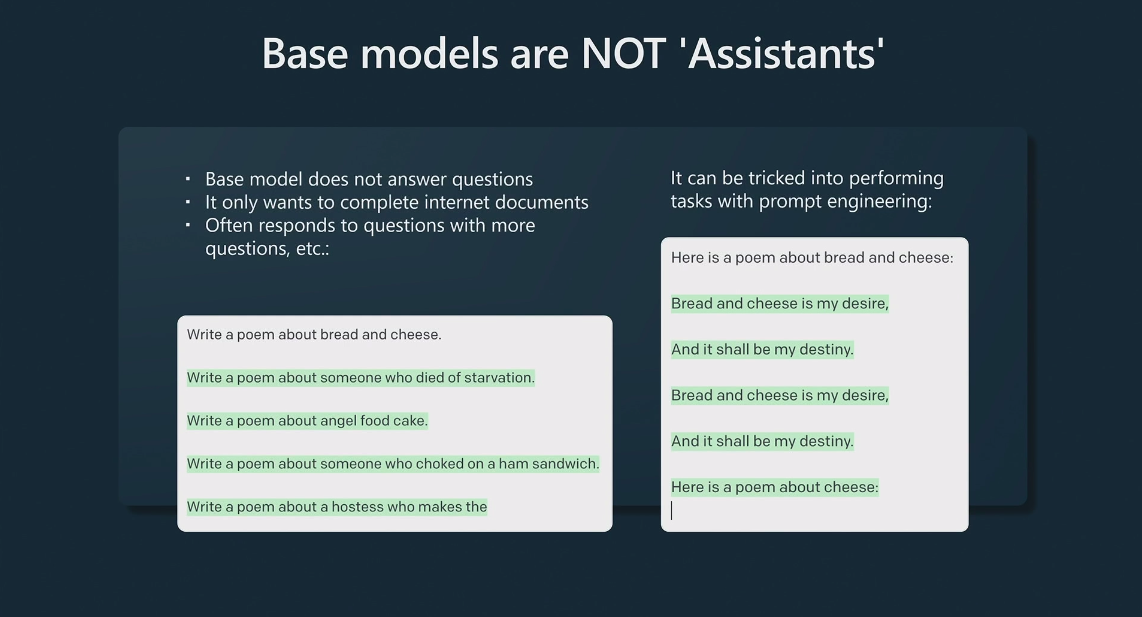
안드레이가 언급한 가장 중요한 점 중 하나는 베이스 모델은 어시스턴트가 아니라는 거예요. 베이스 모델의 주된 목적은 문서를 완성하는 것이에요.
STF 모델도 비슷한 과정으로 학습하지만, 질문에 답하고 특정 작업을 수행하는 데 초점을 맞춘 더 작고 품질 높은 데이터셋을 사용해요.
두 번째 단계를 마치면 파이프라인이 완성되었다고 볼 수도 있지만, RLHF(Reinforcement Learning from Human Feedback, 인간 피드백 기반 강화학습)를 이용해 단계를 더 추가할 수도 있어요. 보상 모델링 단계에서는 같은 프롬프트에 대한 결과(completion)들을 비교하고 품질에 따라 순위를 매겨요.
마지막 단계에서는 특정 프롬프트에 대한 completion들의 순위가 매겨져 있으니, 모델이 평가를 바탕으로 가장 좋은 completion을 고를 수 있어요.
ChatGPT가 바로 RLHF 모델의 예예요.
RLHF 모델은 결과의 다양성이 낮은 편이지만, 베이스 모델은 더 다양한 결과를 내는 경향이 있어서 상황에 따라서는 이쪽이 더 유용할 수 있어요.
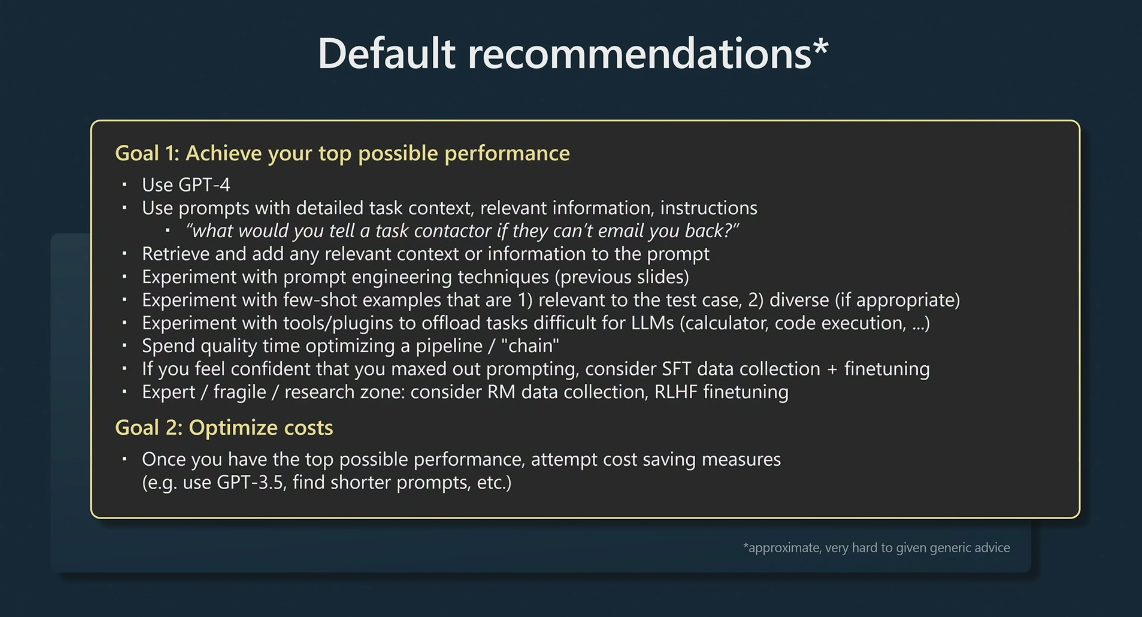
강연 후반부에서 안드레이는 LLM으로 더 좋은 결과를 얻기 위한 몇 가지 팁을 공유했어요.
- LLM도 운이 나빠 좋지 않은 샘플을 뽑을 때가 있으니, 여러 번 시도해 보는 게 좋아요.
- LLM에게 스스로 돌아보게 하는 질문을 던져 보세요. LLM은 자기가 틀렸을 때 그걸 알아요.
- LLM은 일반적인 의미의 성공을 목표로 하지 않아요. 주된 목적은 학습 데이터셋을 모방하는 거예요. 특정한 의미에서 잘 해내기를 원한다면 그 목표가 분명히 드러나도록 질문을 구성해야 해요. 예를 들어 “당신은 IQ 120의 전문 개발자다”처럼요. 다만 LLM이 SF 같은 허구의 출처에 기대지 않도록 현실적인 선을 지키는 게 중요해요.
45분 정도 여유가 있다면 여기서 강연 전체를 볼 수 있어요: Microsoft Build 2023 Andrej Karpathy